
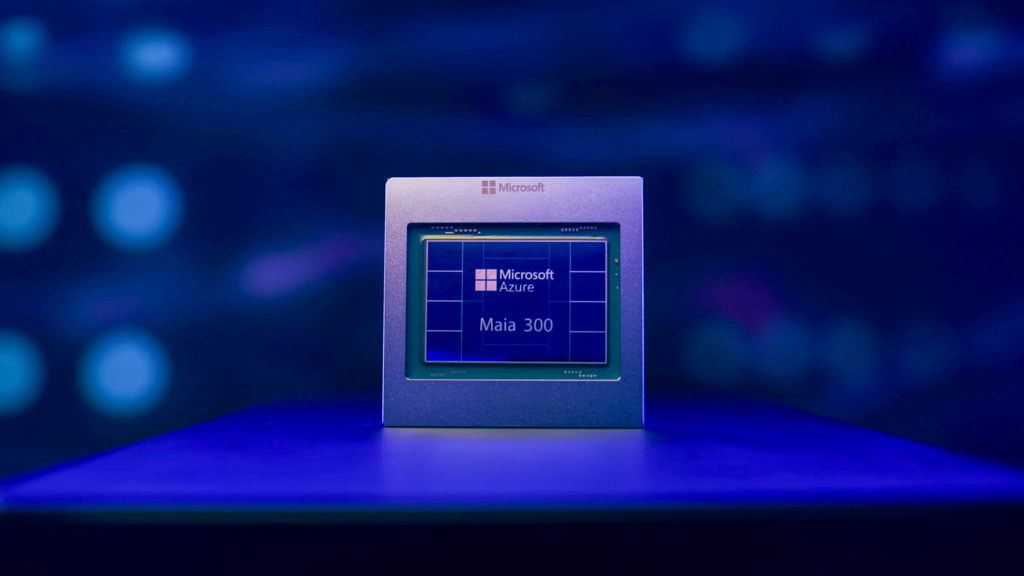
Microsoft ha anunciado Maia 300, la tercera generación de sus aceleradores de inteligencia artificial, con un despliegue previsto para 2027. Este desarrollo busca convertir a Maia en el sistema principal para la inferencia de IA en sus productos y servicios, con el objetivo de escalar a niveles de gigavatios. La iniciativa representa un esfuerzo de Microsoft para disminuir su dependencia de proveedores externos como NVIDIA en su infraestructura de IA.
Cada vez que se utiliza una herramienta de inteligencia artificial, existe una infraestructura compleja detrás para proporcionar una respuesta. Una parte significativa de esta capacidad de procesamiento proviene de los aceleradores de NVIDIA, una compañía que se ha consolidado como un proveedor clave en la industria. Para empresas como Microsoft, que requieren mantener servicios de IA a gran escala, la dependencia de estos procesadores plantea desafíos que van más allá del rendimiento. También son cruciales los costos asociados a la expansión de la infraestructura y el grado de control sobre la tecnología necesaria para el crecimiento continuo.
La respuesta de Microsoft a esta situación se materializa en Maia 300, con un calendario de implementación definido. La compañía estadounidense ha revelado la tercera generación de sus aceleradores de inteligencia artificial, estableciendo el inicio de su despliegue en producción para el año 2027. Esta decisión se alinea con un objetivo más ambicioso: posicionar a Maia como su sistema principal de inferencia para productos y servicios de IA, y expandir sus implementaciones a una escala de varios gigavatios a partir del mismo año. Por el momento, esta es una hoja de ruta anunciada, no una transformación completa de sus centros de datos.
Para comprender la magnitud de esta iniciativa, es importante diferenciar entre dos procesos fundamentales en el funcionamiento de la inteligencia artificial. Por un lado, está el entrenamiento de un modelo, que implica el uso de vastas cantidades de datos para desarrollar sus capacidades. Por otro lado, la inferencia, que se activa cuando un usuario realiza una solicitud y espera una respuesta. Microsoft busca fortalecer específicamente esta segunda tarea con sus propios aceleradores. Este proyecto no parte de cero; la compañía introdujo Maia 100 en 2023, y Maia 200, anunciado en enero de 2026, ya está gestionando cargas de trabajo reales, incluyendo las de Microsoft Copilot. Esta experiencia previa está guiando el desarrollo de la siguiente generación.
Maia 300 no se concibe únicamente como un procesador más potente, sino como un sistema donde la memoria, la computación y las comunicaciones operan de manera coordinada. Su arquitectura incorpora varios chiplets, que son componentes de silicio que distribuyen diversas funciones, y aquellos dedicados al cálculo se fabrican mediante el proceso N2P de TSMC. Además, integra ocho pilas de memoria HBM4, una tecnología que facilita la transferencia de grandes volúmenes de datos a alta velocidad. Microsoft también ha diseñado un sistema de gestión del flujo de información basado en software para minimizar movimientos de datos innecesarios y optimizar el aprovechamiento de los recursos disponibles.
Las cifras divulgadas por Microsoft indican una mejora que la compañía desea medir no solo en rendimiento, sino también en eficiencia energética. Según sus estimaciones, Maia 300 permitirá procesar un 40% más de tokens por megavatio en comparación con algunos de los principales sistemas basados en GPU, aunque no se han especificado los equipos de referencia utilizados. Los tokens son las unidades en las que los modelos dividen el texto y otros contenidos para su procesamiento. Adicionalmente, la compañía afirma que un rack con 96 aceleradores ofrecerá hasta siete veces el rendimiento en tokens por rack de Maia 200, aunque también duplica el número de aceleradores. Estas son comparaciones distintas, basadas en datos del fabricante y aún sin validación independiente publicada.
Para llevar Maia 300 a esta escala, se necesita más que solo la fabricación de chips. Microsoft también está preparando los sistemas completos que los albergarán: cada rack está diseñado para operar dentro de un límite de potencia de 167 kilovatios y permitir la coordinación de un mayor número de aceleradores. Su hoja de ruta contempla iniciar en 2027 una expansión de la familia Maia hacia implementaciones de varios gigavatios, sin una fecha definida para alcanzar este nivel. La escala es un factor crucial, ya que la disponibilidad de electricidad y la capacidad física de las instalaciones determinan el potencial de crecimiento de estos servicios.
La tendencia observada va más allá de Microsoft. Google ya utiliza sus TPU y Amazon ofrece servidores basados en Trainium, lo que ilustra cómo grandes clientes de NVIDIA también están desarrollando soluciones propias. Esto no implica que hayan dejado de recurrir al fabricante estadounidense. De hecho, Amazon y NVIDIA anunciaron en agosto un plan para implementar dos millones de GPU adicionales en AWS entre 2027 y 2028. No obstante, este es un movimiento que merece atención: empresas que requieren una capacidad de procesamiento masiva buscan disponer de tecnología propia para satisfacer parte de esa demanda y disminuir su dependencia de proveedores externos.









